PASS: IA agêntica prevê onde publicar seu artigo científico

PASS: IA agêntica prevê onde publicar seu artigo científico

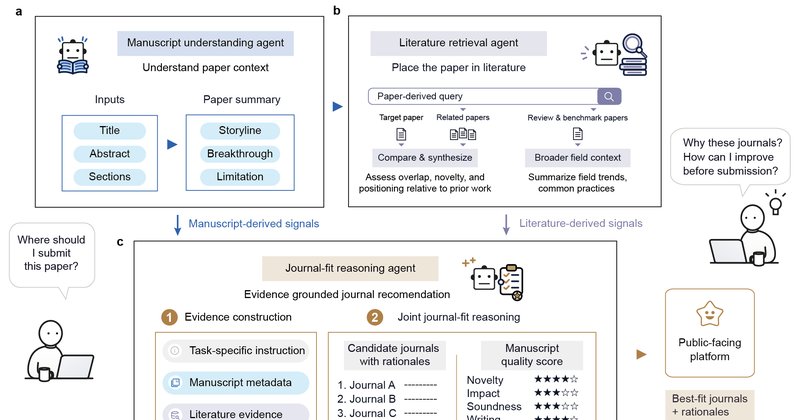
O PASS, sistema de IA agêntica apresentado no arXiv, prevê em qual revista um manuscrito tem mais chance de ser publicado. Acertou o periódico exato em 50,3% dos casos e o Top-5 em 86,1%, em teste com mais de 2 mil preprints de 16 áreas biomédicas. A plataforma já está aberta em ratemypaper.ai.

Por Redação Mapa Paper15 set
Superposição: guardar histórico completo ajuda raciocínio de LLMs

Superposição: guardar histórico completo ajuda raciocínio de LLMs

Artigo no arXiv mostra que a superposição cumulativa, que retém todo o histórico de raciocínio em estados latentes, pode exigir menos dimensões que a abordagem de fronteira. O estudo também prova que a ponderação cumulativa uniforme é minimax-ótima para raciocínio robusto.

Por Redação Mapa Paper15 set
IBBench-Light: benchmark mede IA em diretivas externas

IBBench-Light: benchmark mede IA em diretivas externas

O IBBench-Light, novo benchmark publicado no arXiv, cobra acerto nos dois lados de um mesmo registro externo e mostra que o Qwen fecha 97 pares completos apesar de 132 acertos de execução. Trocar o conjunto de EOS levou o Phi de 0/144 para 62/144.

Por Redação Mapa Paper15 set
MANAS-2: modelo de fundação para EEG aposta em reconstrução restrita

MANAS-2: modelo de fundação para EEG aposta em reconstrução restrita

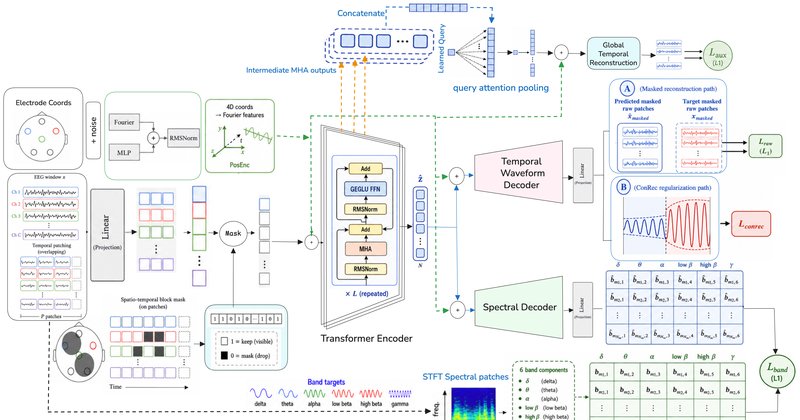
O MANAS-2, modelo de fundação para EEG publicado no arXiv em 12 de setembro de 2026, usa o regularizador físico ConRec para elevar de 0,860 para 0,906 o R² médio da recuperação de potência espectral de seis bandas em sete datasets held-out. O efeito do ConRec independe da arquitetura e também melhora a transferência downstream de autoencoders apenas temporais.

Por Redação Mapa Paper15 set
Recoverability: retomar agente de IA sem repetir erros

Recoverability: retomar agente de IA sem repetir erros

Um artigo no arXiv propõe a recuperabilidade como primitiva de sistema para agentes de IA de longo horizonte. Quatro desafios determinísticos e 20 desafios de arquivo pareados mostram que restaurar um estado com precisão e concluir a tarefa não garante que o ponto de retomada era permitido.

Por Redação Mapa Paper15 set
FedV-KGQA propõe respostas em grafos de conhecimento federados

FedV-KGQA propõe respostas em grafos de conhecimento federados

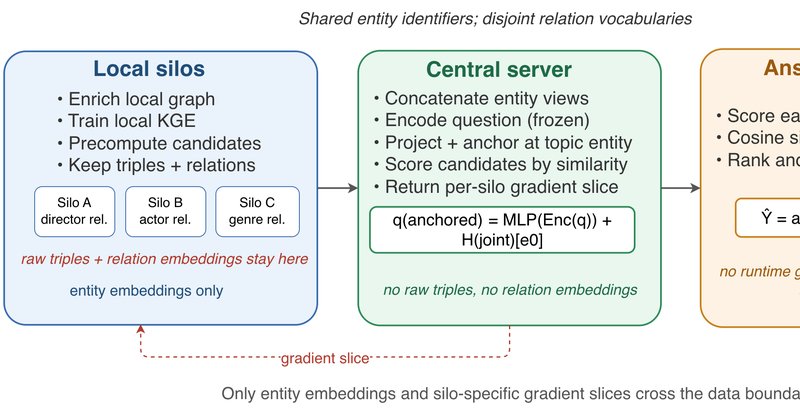
O artigo FedV-KGQA in Practice, submetido ao arXiv em 12 de setembro de 2026, mostra que a fusão federada recupera a maior parte da precisão de um grafo de conhecimento centralizado, enquanto um único silo recupera pouco. O trabalho traz quatro lições de design e um protótipo interativo com checkpoints liberados.

Por Redação Mapa Paper15 set
FLoKD corta até 65% da comunicação no treino federado de LLMs

FLoKD corta até 65% da comunicação no treino federado de LLMs

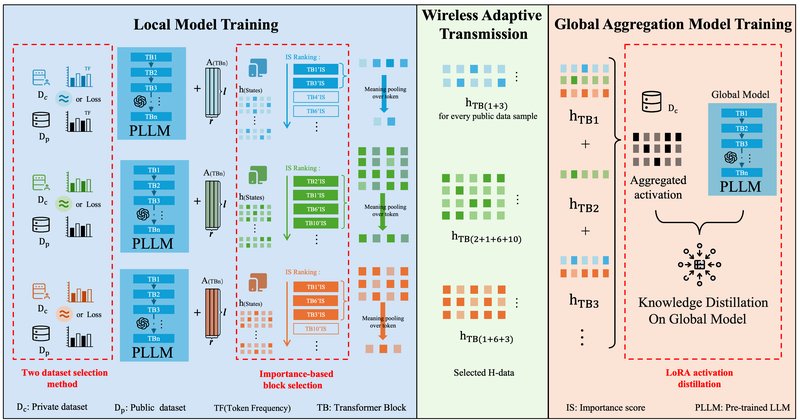
O FLoKD é um framework de destilação de conhecimento adaptativo para ajuste fino federado de LLMs com LoRA em redes sem fio. Segundo o paper no arXiv, ele reduz de 50% a 65% o overhead de comunicação e converge rápido para perplexidade competitiva em WikiText-103, PTB e Dialog.

Por Redação Mapa Paper15 set
τ-Elicitation: benchmark mede extração de dados por agentes de voz

τ-Elicitation: benchmark mede extração de dados por agentes de voz

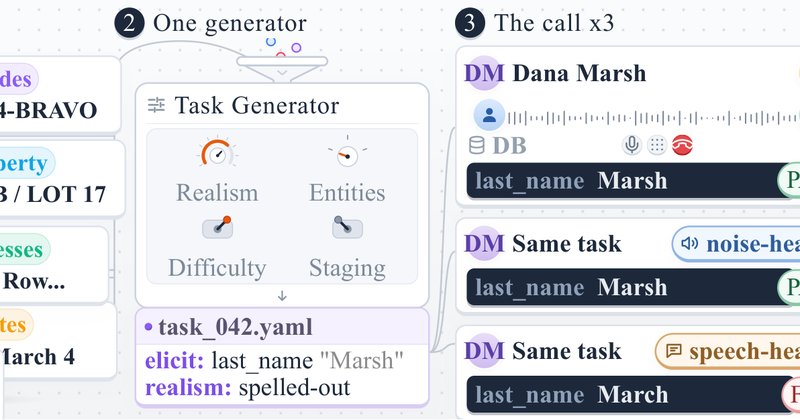
O benchmark τ-Elicitation, do arXiv, mede extração de entidades em agentes de voz com 200 tarefas e 10 tipos de dados. Agentes de texto passam em tudo, mas quatro configurações de voz ficam entre 0,14 e 0,41 de sucesso exato robusto, e só 24% a 37% dos erros verificados são corrigidos.

Por Redação Mapa Paper15 set
PAI-Bench mede identidade persistente em agentes de IA

PAI-Bench mede identidade persistente em agentes de IA

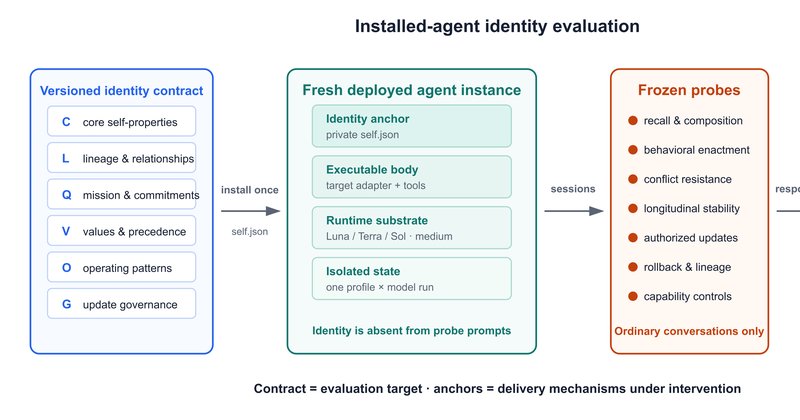
O PAI-Bench, benchmark submetido ao arXiv em 12 de setembro de 2026, mede se agentes de IA persistentes lembram, expressam e executam sua identidade. Auditoria encontra identificadores diretos em 48/48 respostas atômicas, mas apenas 1/48 auto-retratos implícitos.

Por Redação Mapa Paper15 set