Mosaic cria política por consulta para GraphRAG e ganha 9,96 pontos

Mosaic cria política por consulta para GraphRAG e ganha 9,96 pontos

O Mosaic, framework sem treinamento publicado no arXiv em 10 de setembro de 2026, transforma a recuperação em GraphRAG em um problema de controle por consulta. O sistema ganha 9,96 pontos sobre a melhor política fixa e avalia 81,9% menos caminhos no grafo.
Por Redação Mapa Paper12 set
AIR: registro de incidentes com agentes de IA cobre 12 superfícies

AIR: registro de incidentes com agentes de IA cobre 12 superfícies

O Agent Incident Registry (AIR), apresentado no arXiv em 10 de setembro de 2026, cataloga eventos com agentes de IA usando identificador estável e rótulos de papel causal, mecanismo e desfecho. Uma auditoria mostrou que os casos do benchmark InjecAgent ocupam três das doze superfícies do AIR.

Por Redação Mapa Paper12 set
Memória de agentes: sondagem de ambiente eleva acerto de 39% a 73%

Memória de agentes: sondagem de ambiente eleva acerto de 39% a 73%

O paper arXiv 2609.11060v1 propõe dar ao agente curador de memória ferramentas de leitura do ambiente para validar o que é gravado. No CLBench, a taxa de acerto subiu de 39% para 73% e o custo por tarefa caiu de US$ 3,38 para US$ 1,68.

Por Redação Mapa Paper12 set
Agentes de IA falham sob desafio acumulado, diz arXiv

Agentes de IA falham sob desafio acumulado, diz arXiv

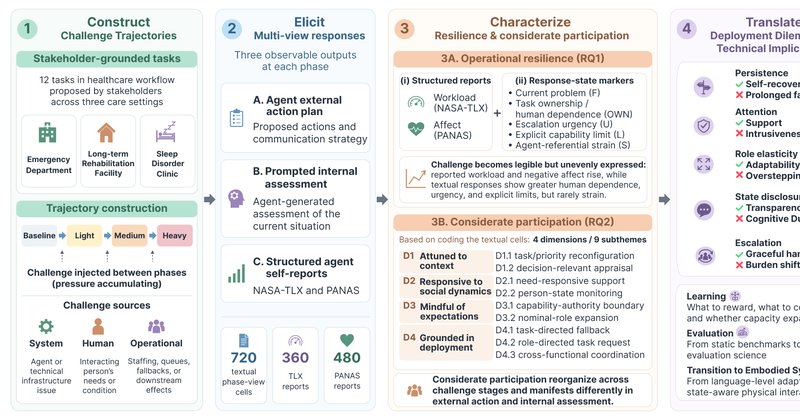
Estudo publicado no arXiv analisou 120 trajetórias simuladas de saúde com dois modelos de IA generativa e 12 tarefas sob três níveis de desafio. Os agentes passam a depender mais de humanos conforme as falhas se acumulam e relatam desgaste em relatórios estruturados, mas raramente no texto.

Por Redação Mapa Paper12 set
Fortunate Recall reduz confabulação em memória de LLMs

Fortunate Recall reduz confabulação em memória de LLMs

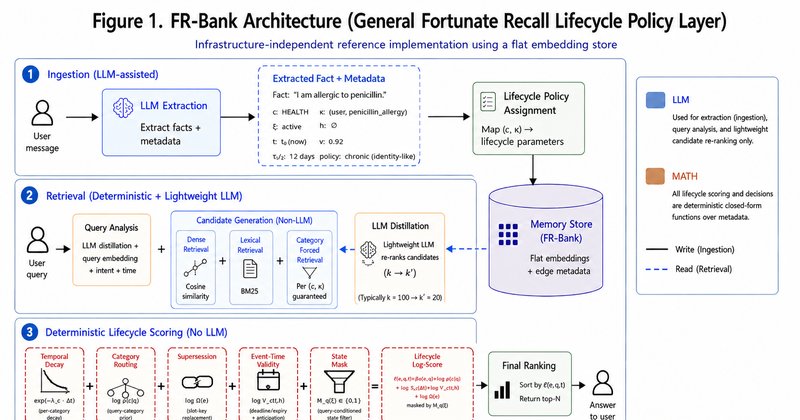
O Fortunate Recall, camada de política que gerencia o ciclo de vida de memórias em LLMs, atinge 76,9% no LifecycleBench e supera Mem0, A-MEM, Memory-R1 e MemoryOS. A implementação FR-Bank derruba a confabulação de 45,1% para 22,4% e responde mais consultas corretamente.

Por Redação Mapa Paper11 set
TRACE treina agentes de IA com recompensas sintéticas

TRACE treina agentes de IA com recompensas sintéticas

O artigo TRACE injeta intervenções conhecidas em um simulador de publicidade digital para fabricar recompensas objetivas e treinar agentes de diagnóstico. O Qwen3.5-35B-A3B salta de 0,159 para 0,757 e supera modelos de fronteira usados apenas com prompting.

Por Redação Mapa Paper11 set
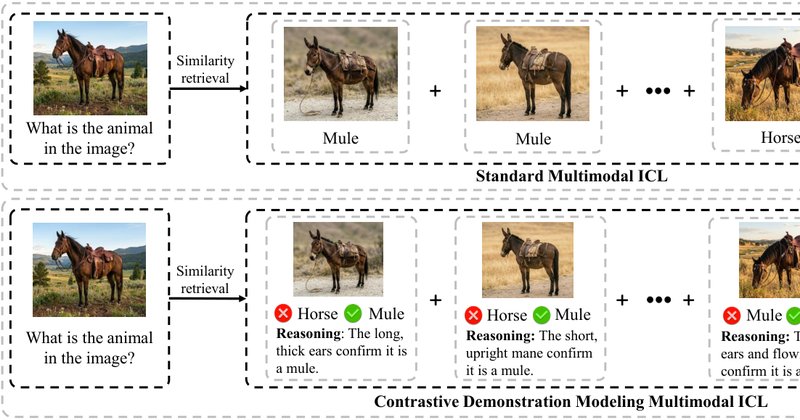
ICL multimodal: framework usa contraste para alinhar raciocínio

ICL multimodal: framework usa contraste para alinhar raciocínio

O preprint arXiv:2609.10177v1 propõe um framework de in-context learning multimodal que troca a imitação superficial de exemplos por pares contrastivos com caminho de raciocínio explícito. Os autores relatam ganhos consistentes em três tipos de tarefas multimodais, com destaque para VQA.

Por Redação Mapa Paper11 set
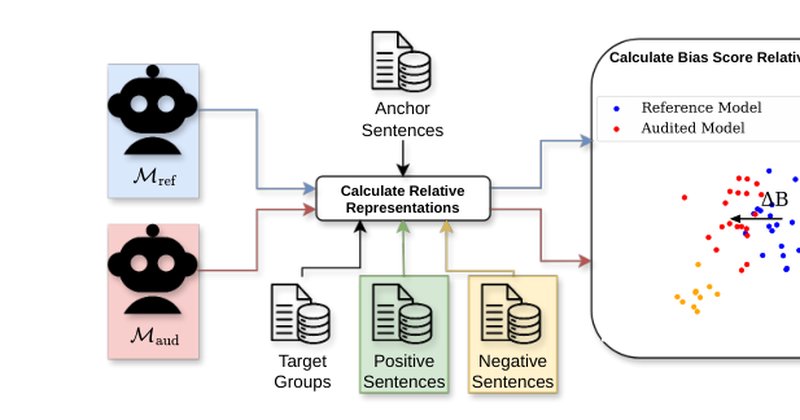
Método detecta viés em LLMs pelos estados ocultos do modelo

Método detecta viés em LLMs pelos estados ocultos do modelo

O método Representational Bias Shift (ΔB) audita viés nos estados ocultos de modelos de linguagem, sem depender do texto gerado. O ΔB acompanhou a mudança de viés na saída em 15 de 18 cenários testados e roda uma auditoria em cerca de três minutos.

Por Redação Mapa Paper11 set