LLMs: estudo propõe estimar incerteza por ambiguidade sem gerar respostas

LLMs: estudo propõe estimar incerteza por ambiguidade sem gerar respostas

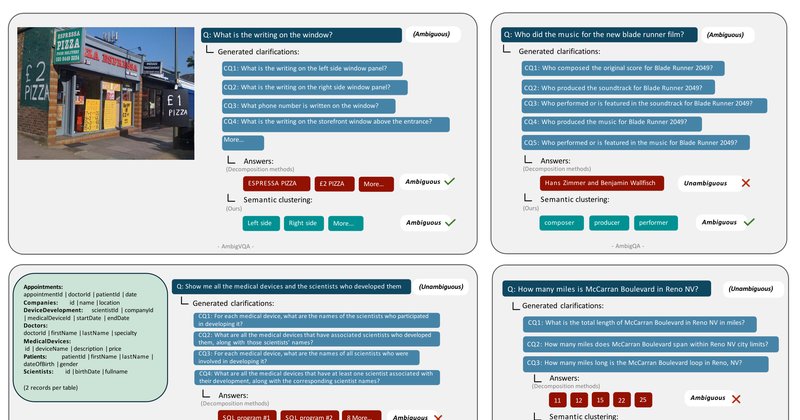
Paper no arXiv (2609.04543, submetido em 3 de setembro de 2026) propõe estimar a incerteza de LLMs causada por perguntas ambíguas apenas a partir das interpretações possíveis, sem gerar respostas. O método eleva o AUROC de 60,85 para 63,34 e reduz o custo em até 26 vezes em tokens de saída.

Por Redação Mapa Paper7 set
Programas como linguagem universal de conceitos: survey em IA

Programas como linguagem universal de conceitos: survey em IA

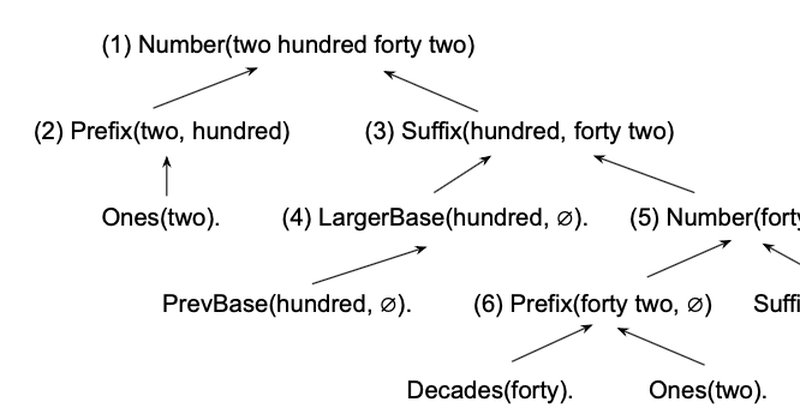
Survey submetido ao arXiv em 3 de setembro de 2026 defende que programas são o candidato mais forte a linguagem universal de conceitos e revisa os modelos computacionais de aprendizado de conceitos baseados nessa representação.

Por Redação Mapa Paper7 set
PerfReasoning: benchmark mede raciocínio de LLMs em performance de hardware

PerfReasoning: benchmark mede raciocínio de LLMs em performance de hardware

Benchmark PerfReasoning, publicado no arXiv em setembro de 2026, mostra que LLMs fechados superam 90% em raciocínio sobre performance de hardware, mas quase todos ficam abaixo de 15% ao gerar código de modelos de performance. Apenas o GPT-5.6 Sol passa de 80% nessa tarefa.

Por Redação Mapa Paper7 set