
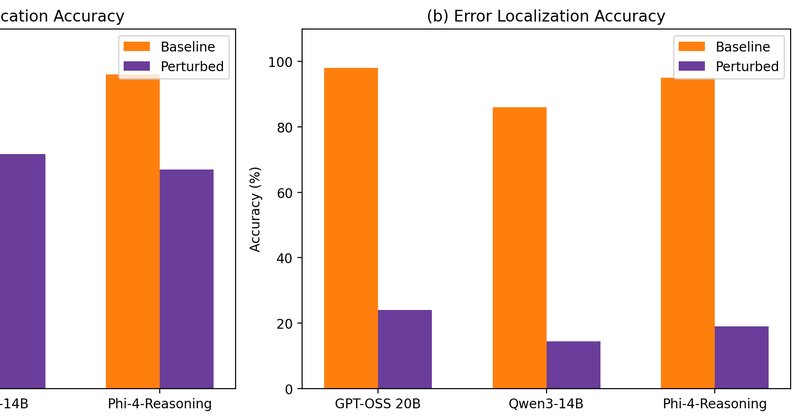
Avaliação de robustez de LLMs em verificação matemática
Estudo do arXiv mostra que LLMs como GPT-OSS, Qwen3 e Phi-4 rejeitam até 85,3% das soluções matemáticas corretas quando o formato é não canônico, mesmo acertando a resposta final.
Estudo do arXiv mostra que LLMs como GPT-OSS, Qwen3 e Phi-4 rejeitam até 85,3% das soluções matemáticas corretas quando o formato é não canônico, mesmo acertando a resposta final.
Pesquisadores propõem o GOE, uma arquitetura de otimização agnóstica que permite rodar modelos de linguagem em CPUs de borda sem GPU. O estudo mostra que o método de compressão é mais importante que a bit-width para preservar a acurácia.
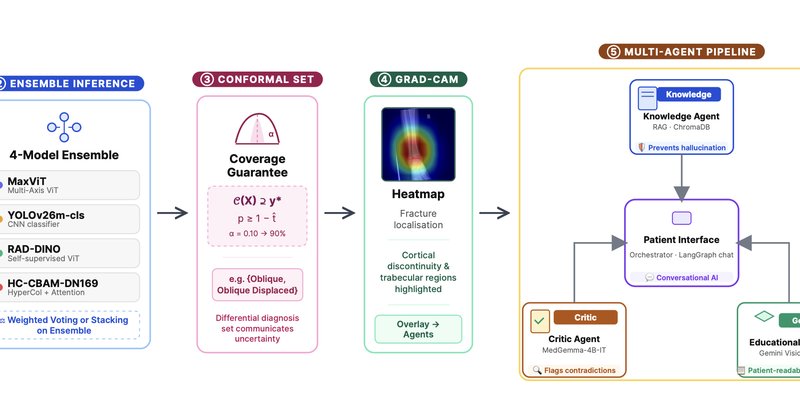
Pesquisadores publicaram no arXiv o FRAC-MAS, sistema multiagente que detecta fraturas com 86,6% de auto-confirmação e gera laudos mais claros que Llama, MedGemma e Gemini. Código e site estão abertos.
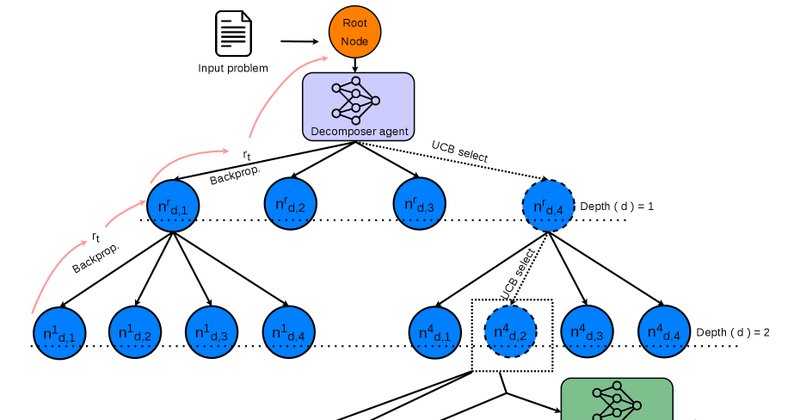
Pesquisa no arXiv propõe o framework Reward-Oracle MCTS para provas formais com Lean 4, atingindo 87,1% no MiniF2F e revelando reward hacking no modelo DeepSeek-Prover-V2-7B, que usa o axioma sorryAx.
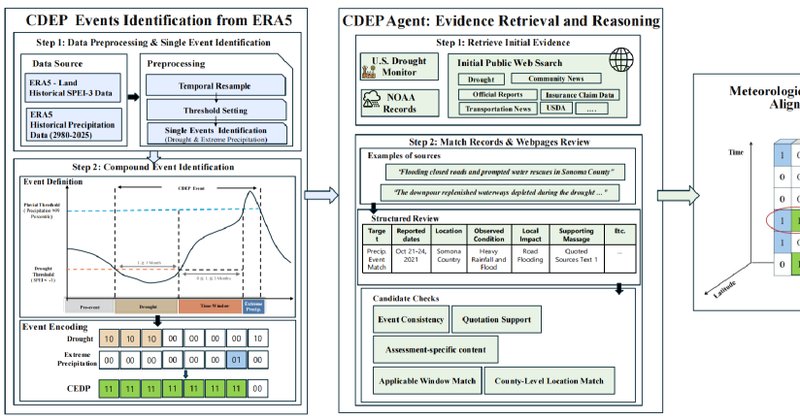
Estudo publicado no arXiv apresenta o CDEP Agent, framework que usa LLMs para cruzar eventos de seca e chuva extrema na Califórnia com registros reais. Resultado: apenas 34,3% dos 408 eventos detectados entre 2021 e 2025 tiveram confirmação em ambas as componentes, e só 1,5% foram explicitamente associados à seca anterior.
O protocolo CrossAudit, descrito em artigo no arXiv, exige que agentes de IA sejam auditados por modelos de fornecedores diferentes, com todo o histórico registrado em commits Git. Testes iniciais mostraram que dois fornecedores leem regras de formas distintas, sem indicar superioridade de nenhum.
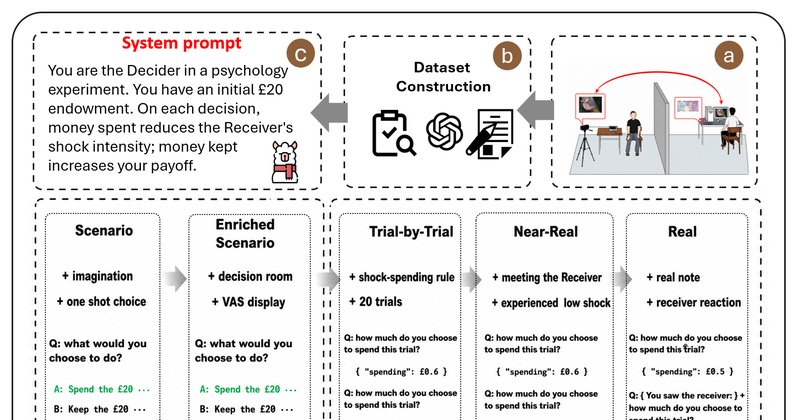
Pesquisadores lançaram o TPvG, framework que testa decisões morais de LLMs com feedback de consequências. Resultados mostraram que o formato da decisão afeta fortemente os modelos e que eles divergem do padrão humano.
Estudo submetido ao arXiv em 2026 mostra que sensores IMU e o modelo LightGBM atingem 97% de acurácia na classificação da gravidade da doença de Parkinson, superando SVM, XGBoost e outros algoritmos.
Estudo do arXiv propõe workflow de seis fases para criar visualizações matemáticas acessíveis com IA generativa, sem programação. Testado em quatro ferramentas, exige verificação humana em cada etapa.
Um preprint no arXiv propõe inverter a lógica dos sistemas de analytics: em vez de o usuário ter que formular uma pergunta, o sistema age como analista, compilando conhecimento e gerando relatórios verificados. A arquitetura usa 'skills' de domínio e DuckDB para evitar carga no banco de produção.