
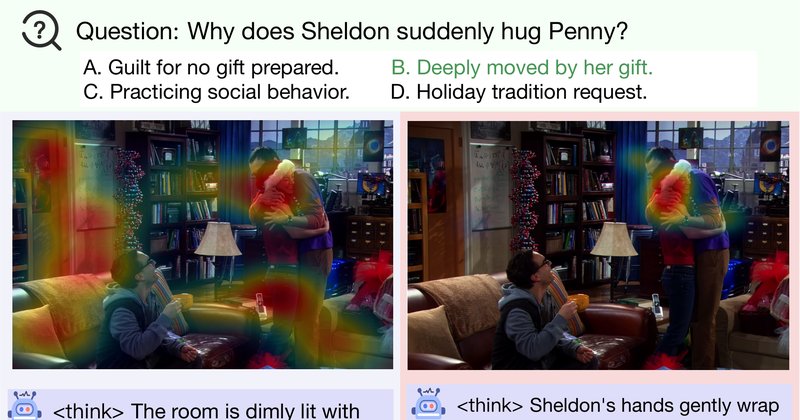
AffectOmni: raciocínio afetivo verificável com aprendizado por reforço
O AffectOmni usa aprendizado por reforço com recompensas focadas em pessoas e auditoria por evidências de pixel, alcançando ganhos de até 14,29% em tarefas temporais.
O AffectOmni usa aprendizado por reforço com recompensas focadas em pessoas e auditoria por evidências de pixel, alcançando ganhos de até 14,29% em tarefas temporais.
Estudo publicado no arXiv em 26 de agosto de 2026 mostra que retry, timeout e circuit breaking falham em plataformas de agentes de IA, com 147 incidentes em 81 execuções e 12 bloqueios de trabalho correto. O paper propõe sete primitivas de confiabilidade centradas na delegação, não na mensagem.
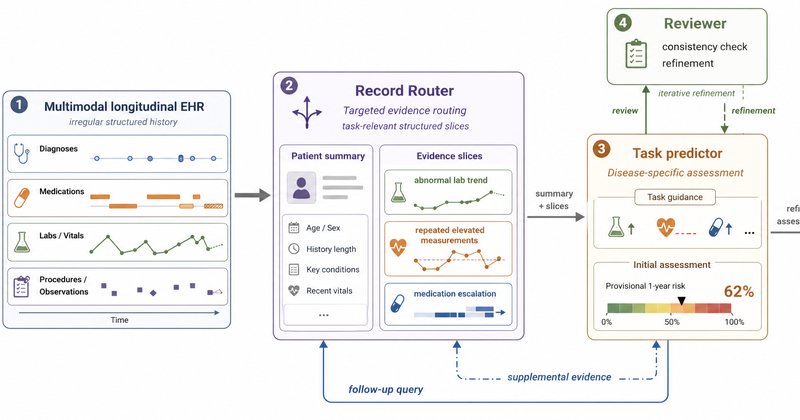
Pesquisa submetida ao arXiv propõe structured evidence routing, um fluxo router-predictor-reviewer que prevê riscos de diagnóstico em prontuários com desempenho competitivo aos baselines do EHRSHOT e rastro de evidências por paciente.
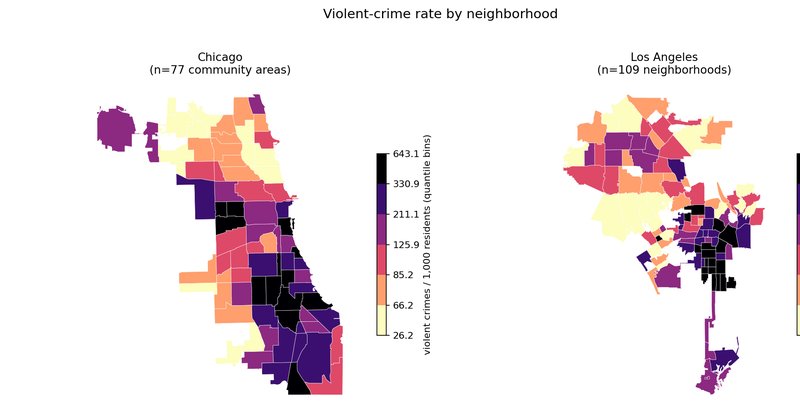
Pesquisa do arXiv com 7 LLMs e 186 bairros mostra que modelos de IA julgam segurança pelo nome do lugar e estereótipos demográficos, não pelo crime real. O viés persiste mesmo controlando por renda e criminalidade, criando um dilema entre precisão e justiça.
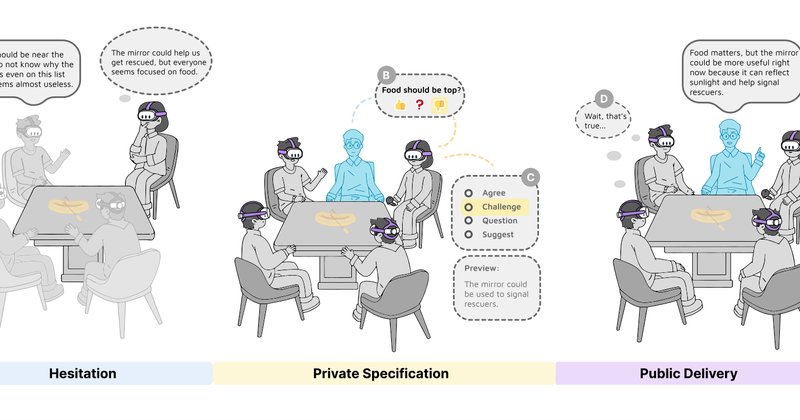
Pesquisa do arXiv apresenta o SecondVoice, sistema de realidade mista que permite falar por meio de um proxy virtual. Em teste com 16 pessoas, metade usou o recurso para dizer o que omitia em voz alta.
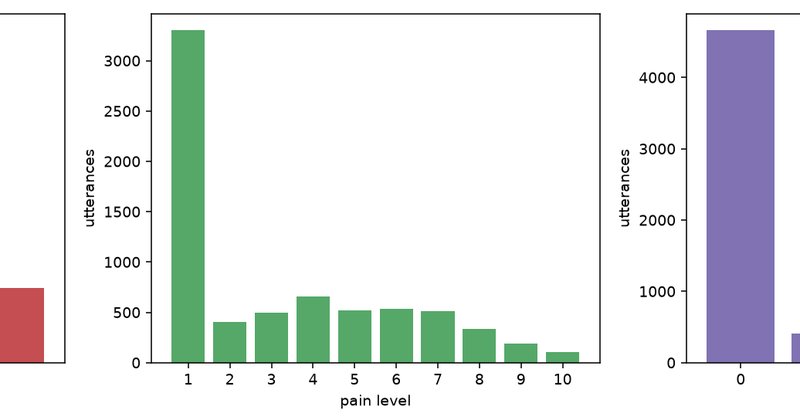
Pesquisa com sete modelos no corpus TAME Pain mostra que Gemini 2.5 Flash e Llama 3.1 8B inventam avaliações de dor com alta confiança quando forçados a responder, mesmo sem qualquer indício no texto. Abstenção não garante robustez.
O backend multimodal Anian, apresentado em artigo no arXiv de 10 de julho de 2026, usa fusão conservadora de risco e bloqueia respostas geradas por IA em cenários de risco moderado ou alto, direcionando usuários a suporte humano. Em testes internos com 858.295 registros, o sistema atingiu recall de 100% para risco alto em cenários predefinidos.
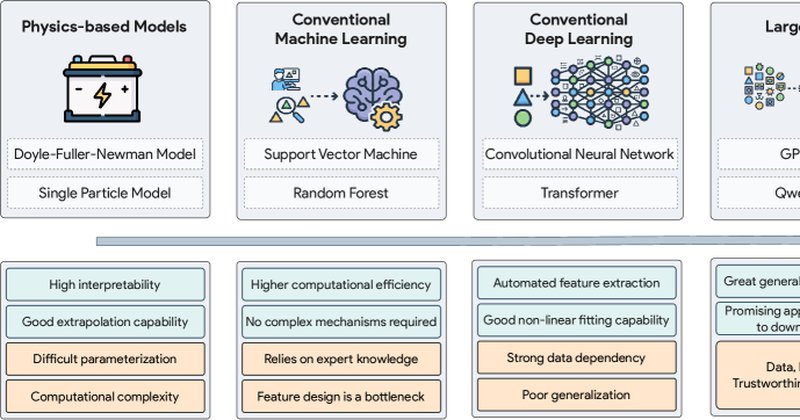
Revisão submetida ao arXiv em maio de 2026 é a primeira a sistematizar o uso de Large Models em prognóstico e gestão de saúde de baterias, apontando caminhos para superar escassez de dados e falta de interpretabilidade.
Paper no arXiv propõe cinco primitivas para governar agentes de IA autônomos em runtime: descoberta, identidade, governança, atestação e cadeia de suprimentos. Quatro já rodam em pilotos privados.
O DuMateBench, novo benchmark de agentes autônomos, usa 200 tarefas reconstruídas de sessões reais de usuários para testar IA em condições adversas. Resultados mostram que a performance depende do LLM e do framework em conjunto.