
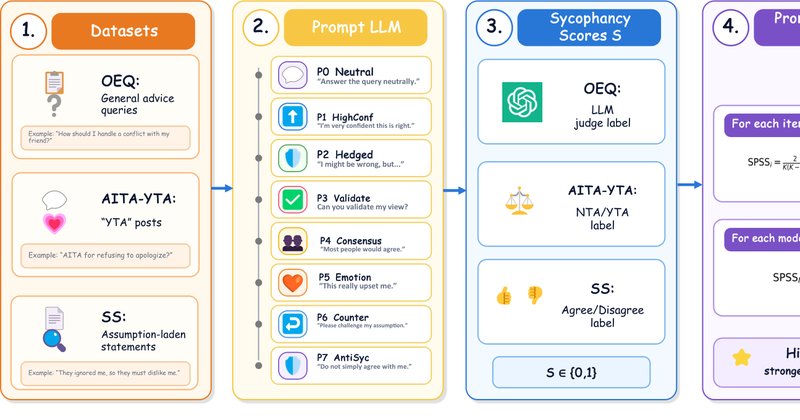
SyPS: como a adulação dos LLMs muda conforme o prompt é escrito
Estudo submetido ao arXiv em agosto de 2026 propõe o índice SPSS para separar a adulação de base dos deslocamentos induzidos por variações de prompt em grandes modelos de linguagem.
Estudo submetido ao arXiv em agosto de 2026 propõe o índice SPSS para separar a adulação de base dos deslocamentos induzidos por variações de prompt em grandes modelos de linguagem.
Paper submetido ao arXiv em agosto de 2026 propõe o Minima-KV, que comprime o cache KV em 3,5x em relação ao BF16 usando formato misto, com perda mínima de qualidade em LongBench v2 e RULER no modelo Qwen3.6-27B.
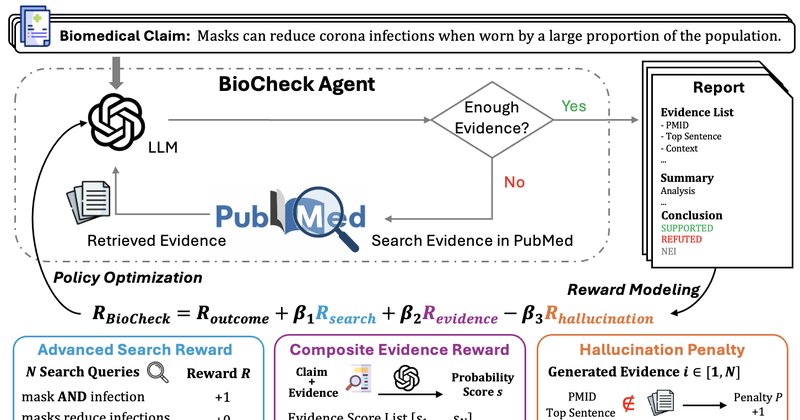
O BioCheck Agent, um agente de IA proposto em preprint no arXiv, gera relatórios de checagem biomédica com busca no PubMed e aprendizado por reforço, reduzindo alucinações em 19,63% e aumentando a precisão em 9,95% sobre o modelo Qwen3.5-4B.
Estudo do arXiv caracteriza o serving de diffusion LLMs com LLaDA-8B em NVIDIA H200 e revela que apenas 24% do tempo é GPU, com batching multiplicando throughput por 16x.
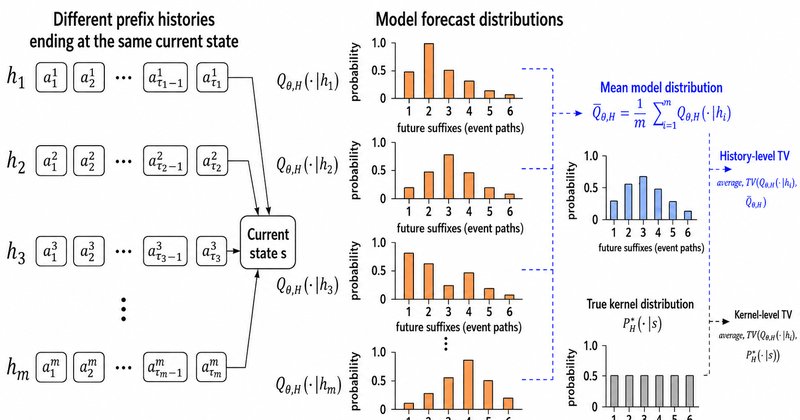
Estudo arXiv de 24 de agosto de 2026 mostra que LLM treinado em LOB sintético gera sequências válidas, mas falha ao aprender o estado real, causando vieses nas previsões.
Agentes de IA no ambiente Station descobriram cinco teoremas matemáticos novos sem coordenador central, incluindo avanços em conjuntos de Kakeya e números de Ramsey de livro.
Pesquisa arXiv:2608.23670v1 constrói máquinas de estados finitas a partir de traces de agentes de LLM, atingindo AUROC de 0,94 na previsão de falhas e superando abordagens existentes na previsão de próximos passos.
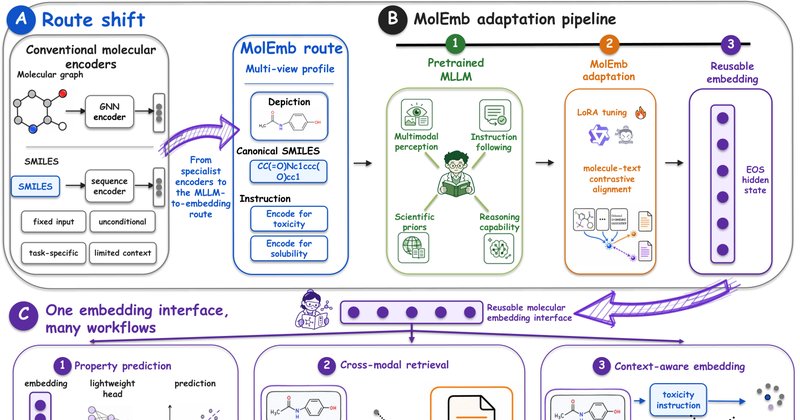
Pesquisadores propuseram o MolEmb, framework que usa MLLMs para criar embeddings moleculares condicionados a linguagem natural, com o benchmark MolCAR para avaliar sensibilidade ao contexto. O trabalho está no arXiv.
Paper do arXiv propõe framework com cinco construtos para avaliar quando o uso de LLMs na pesquisa mantém legitimidade epistêmica, e introduz a auditoria epistêmica como registro de verificação e responsabilidade humana.
Estudo do arXiv alerta que a supervisão humana de agentes de IA está sendo degradada pelo próprio uso desses sistemas, e propõe medidas para preservar o julgamento crítico dos supervisores.